OpenAI GPT 配置(中文)
Liquid Agent 默认使用 OpenAI GPT API,通过 https://api.openai.com/v1 的 Responses API 调用。Web 和 CLI 共用 Codex 对话控制器、凭据/模型策略及 LangGraph 科学执行层。内部服务与显式既有诊断仍可直接使用 SDK 请求。更换模型不会替代液体活检知识、skills、数据集上下文、工具检查、取消或步骤之间的用户审阅。
在同一对话内切换 GPT 型号、提供方或本地配置,会保留安全对话上下文、附件、当前计划、已完成结果和任务记忆。较早的相关决定超出模型近期上下文时,可以从任务检查点检索。这表示任务证据得到保留,并不承诺每个模型都能在提示中逐字容纳全部历史。真正修改历史会使过时上下文失效;提供方的隐私规则仍然适用。
模型选择
审查后的目录位于 agent/openai_models.py。截至 2026 年 10 月 4 日:
| Web 模型名称 | 选择方式 | 策略 |
|---|---|---|
| GPT-6.1 Sol | gpt-6.1-sol |
显式选择 GPT-6.1 Sol |
| GPT-6 Astra | gpt-6-astra |
显式选择的旗舰型号,Token 单价更高 |
| GPT-6 Sol | gpt-6-sol |
适合复杂智能体任务、需显式选择的更高能力档位 |
| GPT-6 Luna | auto |
原有经济型默认值;本次目录更新不改变它 |
| GPT-5.6 Sol | gpt-5.6-sol |
显式选择 GPT-5.6 Sol |
| GPT-5.6 Terra | gpt-5.6-terra |
显式选择 GPT-5.6 Terra |
| GPT-5.6 Luna | gpt-5.6-luna |
显式选择 GPT-5.6 Luna |
Web 菜单仅显示加粗的模型名称及同一行的密钥状态,中间以灰色细竖线分隔,不显示档位标题。未配置密钥时,状态以红色显示。GPT 排序为 GPT-6.1 Sol、GPT-6 Astra、GPT-6 Sol、GPT-6 Luna、GPT-5.6 Sol、GPT-5.6 Terra、GPT-5.6 Luna。GPT-6 Luna 入口使用 auto 选择;菜单顺序不改变默认型号。
目录保留既有 GPT-6 选项,并加入 GPT-5.6 Luna、Terra、Sol 和 GPT-6.1 Sol。auto 仍解析为 gpt-6-luna;其他入口需手动选择,并使用同一 OpenAI 密钥。已有显式固定型号(包括较旧 GPT ID)不会被静默改写。工具型智能体请求均通过 Responses API;请求使用 low 推理强度,不发送不支持的采样参数。菜单中出现型号不代表账户获得访问权限,也不证明某个密钥可以调用该型号。账户访问权限与价格可能变化。权威参考是模型目录、价格、最新模型指南和更新日志。新增 ID 见官方 GPT-5.6 Luna、GPT-5.6 Terra、GPT-5.6 Sol 与 GPT-6.1 Sol 页面。
Web 选择器从 /api/llm/config 获取目录,不另存第二份模型 ID 列表。CLI 也接受固定的 gpt-* 模型 ID。经济目录更新时,已保存的显式选择不变。目录和适配器更新在重启本地服务后生效;不会在分析途中热切换实现。模型不可用时,应用报告错误,绝不静默切换提供商或升级到更昂贵模型。
新模型发布不一定需要重写 API 适配器。端点及支持的请求参数兼容时,通常只需更新审查后的选择目录;CLI 已接受显式 gpt-* ID。端点或参数变化、SDK 不兼容及模型弃用需要有针对性的兼容审查,必要时修改适配器。应用不会在运行时自动发现或选择新模型;更新目录不会改变 auto 或已保存的固定型号。
/llm models
/llm key
/llm use auto
/llm save
显式选择更高档位:
/llm use gpt-6-astra
/llm save
liquid-agent llm-configure 提供交互式设置。优先使用隐藏密钥输入或 OPENAI_API_KEY,不要将密钥放在命令行参数中。
型号选项可单独滚动,Manage local models 与 Manage keys 管理入口始终显示在菜单底部。Gemini 的界面名称为 Gemini-3.8-Flash;API 模型 ID 仍为 gemini-3.8-flash。
可选 Gemini
支持的 Gemini 选项为 gemini-3.8-flash。官方列明标准 API 的输入、输出有免费层,支持函数调用和结构化输出。根据其面向 Agent 工作流的官方能力说明,我们将其选为优先免费层候选;这不是本项目的模型性能排名。这不是保证免费的模型开关。能否使用及是否收费取决于 Google 项目的套餐、资格和当前配额。请先检查定价及 Google AI Studio 中的限制,不要仅为了跟随教程而开启计费。
若只允许使用 Free Tier,请在 AI Studio 新建或选择独立项目,确认 Billing Tier 为 Free Tier 且未开通计费,再使用该项目的 Gemini Key。保持计费关闭,不要为解决配额错误而开启付费或自动充值。保存型号无法检查或控制 Google 的计费状态;OpenAI Key 与 Gemini Key 独立。配额错误会停止请求,不转为付费调用;免费容量与持续可用性无法保证。见 Google 计费说明。
仅使用公开或不敏感的合成数据。免费服务的提示和回答可能被用于改进 Google 产品。Google 条款 包含地区限制,以及欧洲经济区、英国和瑞士的 API 客户端付费服务要求。本地隐私网关仍然有效,但汇总信息并不自动意味着适合向外披露。
Web 中,在输入框模型菜单选择 gemini-3.8-flash,阅读提示并输入 Gemini API 密钥。管理 API 密钥中的服务商选择器可分别添加或替换密钥;删除一家密钥不会删除另一家。保存配置不验证 Google 计费状态,也不证明密钥有效,实际调用时会显示 API 错误。
Web 菜单只显示一个 Gemini 入口。之前保存的 gemini-3.5-flash-lite 仍保持固定,管理密钥也会保留该选择,但旧型号不再单独列在 Web 菜单中。升级时请明确选择推荐型号,已有密钥会保留。/llm use gemini 默认解析为 gemini-3.8-flash;产品默认服务商仍为 OpenAI。
终端 Shell 中:
/llm key gemini
/llm use gemini
/llm save
也可运行 liquid-agent llm-configure --llm-provider gemini,通过隐藏输入配置密钥,或设置 GEMINI_API_KEY(也识别 GOOGLE_API_KEY)。/llm use auto 显式切回 GPT;/llm delete gemini 删除 Gemini 密钥并禁止从环境变量重新启用它。
Gemini 使用原生函数调用适配器,不经过 Codex 的 Responses 通信层;它复用相同的对话控制器、skills、隐私网关、本地工具验证、LangGraph 执行和报告/历史归属机制,不是另造固定流程。原生工具调用签名保留在本地对话记录中,用于续接。停止仅取消当前请求,不关闭 Web 服务。额度或认证失败会直接报错,不自动重试、切换提供商、开启计费或升级模型。
凭据与迁移
在 Web 模型菜单中使用 Manage keys 添加、替换或删除 OpenAI 密钥。一个密钥服务于所有 GPT 档位。更换模型时留空密钥输入会保留已保存密钥。配置被拒绝时,弹窗不会关闭或假装成功。保存密钥只是存储,不证明 OpenAI 接受它或账户有余额。API 调用时显示请求错误。
配置存储在操作系统用户配置目录中的 llm_config.json:
- macOS:
~/Library/Application Support/liquidbiopsy_agent/ - Linux:
~/.config/liquidbiopsy_agent/ - Windows:
%LOCALAPPDATA%/liquidbiopsy_agent/
写入使用私有临时文件、原子替换,以及 POSIX 上仅所有者可访问的文件权限。密钥使用 Fernet 认证加密,主密钥保存在操作系统凭据库;凭据库不可用或被锁定时明确报错,不回退到明文。请保护用户账户和备份。返回 UI 的 API 响应只包含密钥存在标记,不包含保存的秘密值。密钥不存于浏览器持久化或图检查点。
CLI 和 Web 都支持通过 LIQUIDBIOPSY_CONFIG_DIR 指定配置目录,包括数据盘中的目录。请选择源码目录和任何 Git 仓库之外的私有目录。例如在 macOS 上:
export LIQUIDBIOPSY_CONFIG_DIR="/Volumes/YourDataDisk/liquid-agent-private/config"
liquid-agent web
启动终端 liquid-agent 时使用同一个环境变量。此后输入的 Key 会保存到指定目录的 llm_config.json。设置变量不会迁移或删除原有凭据;如果目标目录为空,需要重新输入 Key。使用期间需保持数据盘挂载。默认保存位置仍是源码目录之外的操作系统用户配置目录。Git 忽略规则也排除了本地 .env 和 llm_config.json,但忽略规则无法清除已经提交到 Git 历史的文件。
旧配置在读取时迁移。旧版 OpenAI-only 迁移已移除的凭据不会复活;新版 schema 3 独立保存 OpenAI 和用户新添加的 Gemini 配置,并移除不支持的提供商、代理端点和本地模型路径。已固定的 GPT ID 继续固定。选择 auto 采用经济默认值。通用旧 API key 与 base URL 环境变量被忽略,防止意外跨提供商路由。
启动器在 Conda 激活时保留调用者提供的 OPENAI_API_KEY,防止陈旧 Conda 环境变量替换它。已保存 OpenAI 设置仍优先于环境密钥。如果已安装命令包装器早于此启动环境修复,升级后用安装程序重新生成。
删除密钥会禁用后续请求,包括来自已有客户端对象的请求,并记录不得静默重新启用 OPENAI_API_KEY。添加新密钥可恢复访问。此操作不会从 Shell 移除变量,也无法撤回已发往 OpenAI 的请求。模型变化影响选定会话和新会话默认值,不改变其他活跃会话的显式模型选择。
请求与失败处理
直接 Python SDK 适配器对 GPT-5 和 GPT-6 请求使用低推理强度。默认输出预算为 2,400 tokens,包括推理;不完整输出会被拒绝,不会作为部分工具决策分发。可选 LIQUIDBIOPSY_LLM_MAX_TOKENS 和 LIQUIDBIOPSY_LLM_TIMEOUT 调整预算与每请求超时。瞬时失败默认在同一模型上重试一次,再进入短暂冷却。认证失败不会换模型或提供商重试。
直接 SDK 适配器设置 store=false;Liquid Agent 显式提供本地对话和领域上下文。此标记不承诺 OpenAI 零保留。发送敏感研究数据前,应审阅 OpenAI 数据控制。现有本地科学工具仍在本地处理数据;模型提示可能包含用户问题、数据集元数据、选定汇总及检索到的项目/skill 上下文。
Codex 对话运行时管理自己的多轮 Responses 请求,使用相同配置的 API key/模型及低推理强度,但不能假设 SDK 适配器的 LIQUIDBIOPSY_LLM_MAX_TOKENS、超时、冷却或 store=false 实现同样支配 Codex 请求。Codex 有独立的轮次/工具调用限制,并保留本地对话状态。发送敏感研究信息前,验证部署的 Codex 版本与 OpenAI 账户数据控制;此集成不认证零保留。
/llm off 仍提供离线诊断。任何确定性恢复信息都不是成功的实时 GPT 回答。
实操工作区中的密钥入口
点击输入框旁的模型选择器,再点 Manage keys。下图输入框为空,不会显示任何凭据。
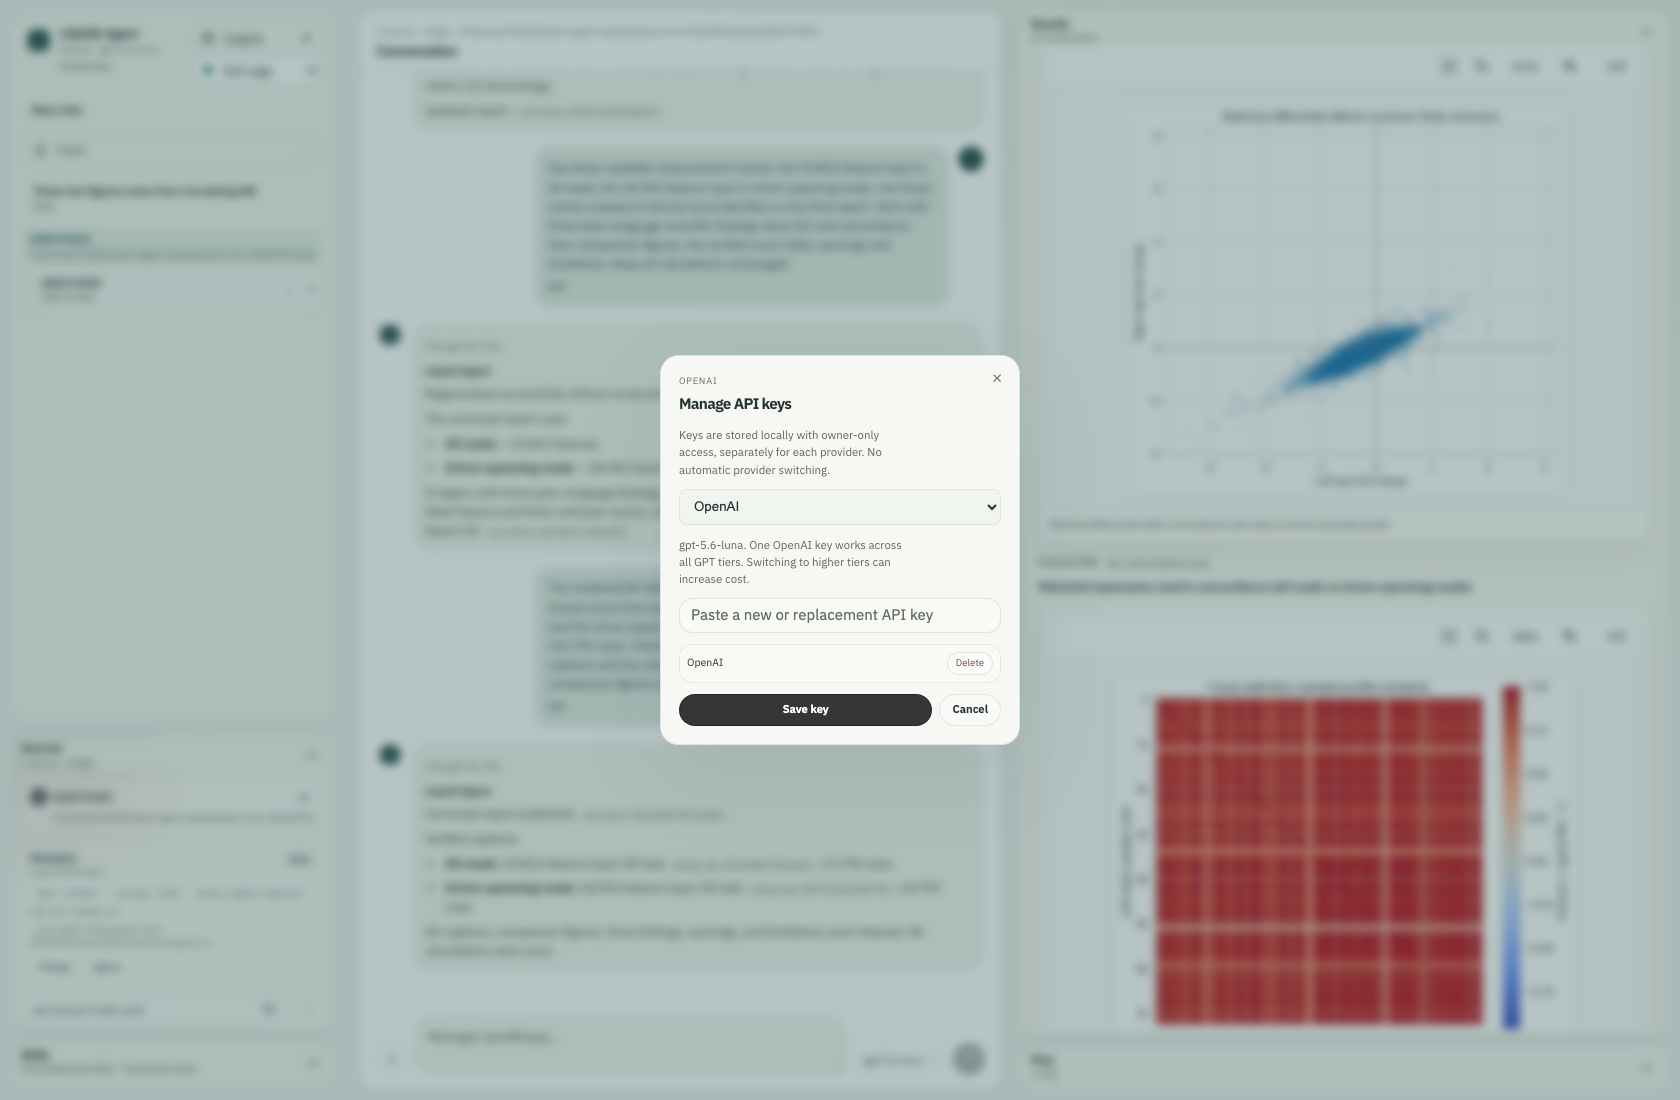
实际密钥管理弹窗,不显示凭据。